Telco Customer Churn
Previsão de churn de clientes com base em padrões de serviço, contrato e faturamento.
Modelo selecionado: HistGradientBoostingClassifier
01 — Visão geral
O churn de clientes é um problema de classificação binária em que o objetivo é identificar padrões preditivos associados a contas classificadas como Churn = Yes.
Este estudo analisa 7.043 contas de clientes utilizando 19 variáveis de modelagem relacionadas a perfil do cliente, tempo de permanência, serviços contratados, condições de contrato, faturamento, forma de pagamento e valores cobrados. customerID é tratado exclusivamente como identificador e não participa da modelagem.
O objetivo é preditivo, e não causal: o estudo investiga se as características observadas das contas contêm sinal útil para distinguir churn de não churn. Ele não demonstra que alterar individualmente uma dessas características modificaria o comportamento futuro do cliente.
O trabalho foi estruturado como um estudo científico reprodutível, abrangendo verificação da fonte, preparação determinística, definição do holdout, análise exploratória restrita ao treino, comparação entre famílias de modelos, seleção previamente definida, avaliação final e evidências de reprodutibilidade.
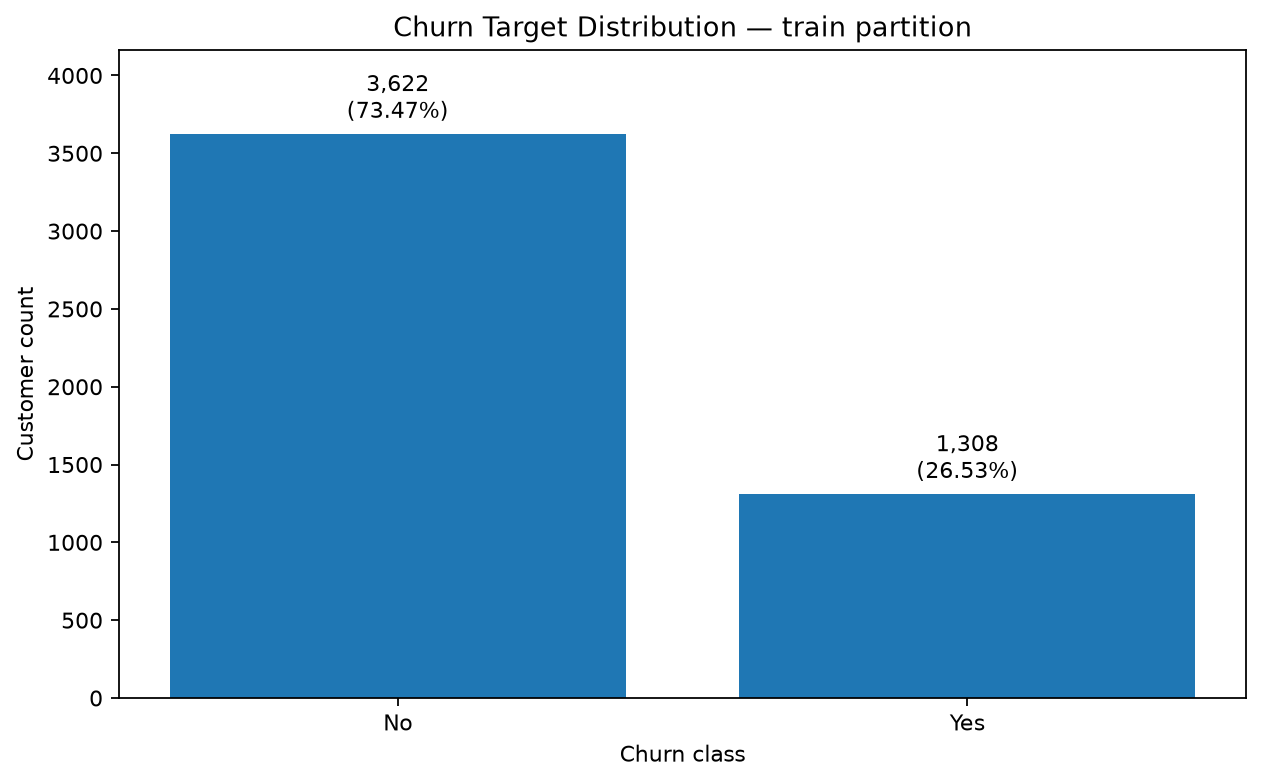
A partição de treino utilizada na análise dependente do target contém 4.930 contas, das quais 3.622 pertencem à classe Churn = No e 1.308 à classe Churn = Yes. Essa distribuição corresponde a aproximadamente 26,5% de exemplos positivos e ajuda a justificar o uso de métricas sensíveis à recuperação da classe minoritária, principalmente Average Precision.
02 — O que os dados revelaram
A análise exploratória que utiliza o target é realizada somente sobre a partição de treino, composta por 4.930 contas de clientes.
Um dos padrões mais claros aparece no tipo de contrato. A taxa de churn observada varia de forma expressiva entre as categorias:
Mensal — 43,15%
Um ano — 10,60%
Dois anos — 2,94%
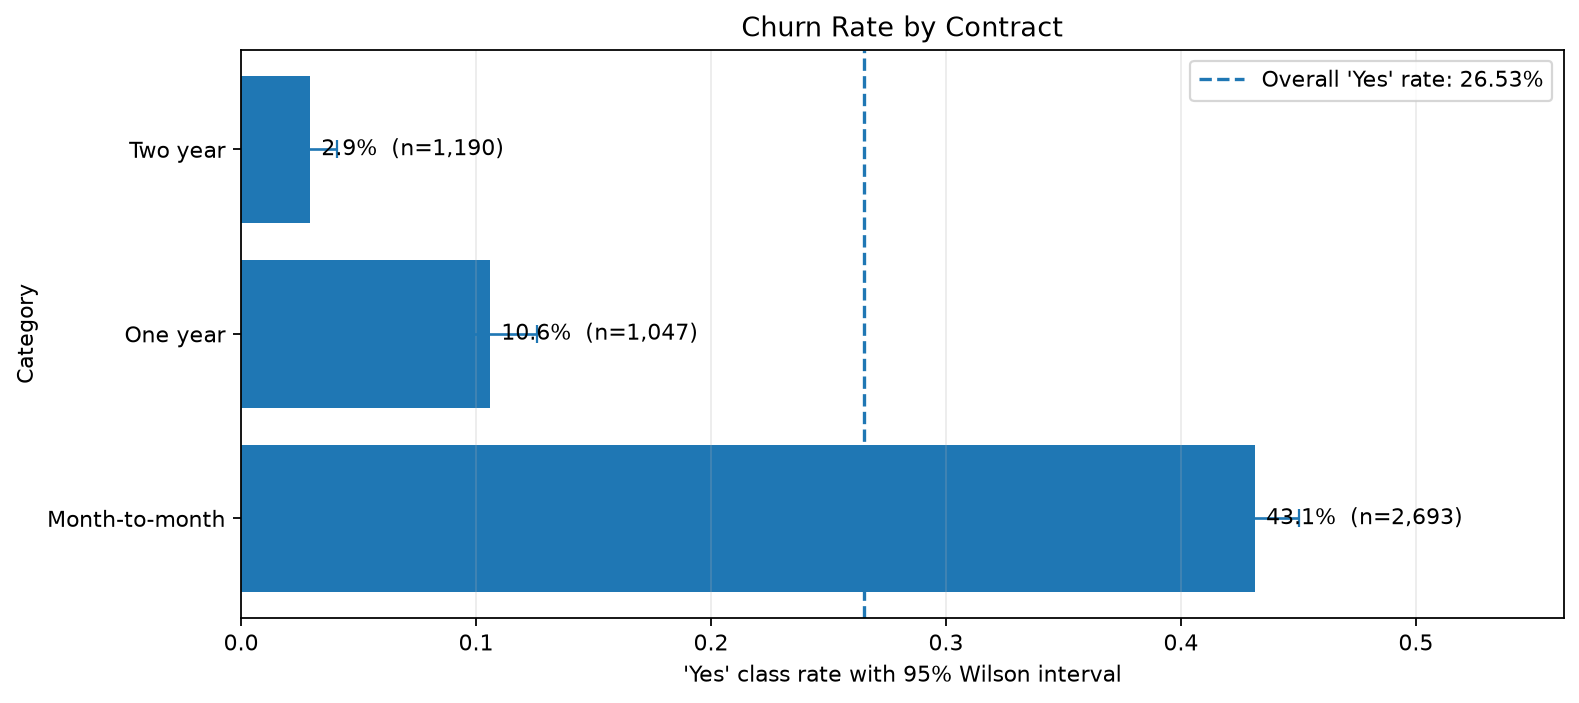
As contas com contrato mensal apresentam churn observado consideravelmente maior do que aquelas com contratos mais longos. Esse resultado representa evidência preditiva, e não demonstra que transferir um cliente para um contrato mais longo evitaria o churn de forma independente.
O tempo de permanência também apresenta um padrão forte. Entre os grupos analisados pelo estudo, o churn observado diminui de aproximadamente 59,5% entre as contas com menor tempo de permanência para aproximadamente 3,5% entre as contas com maior permanência.
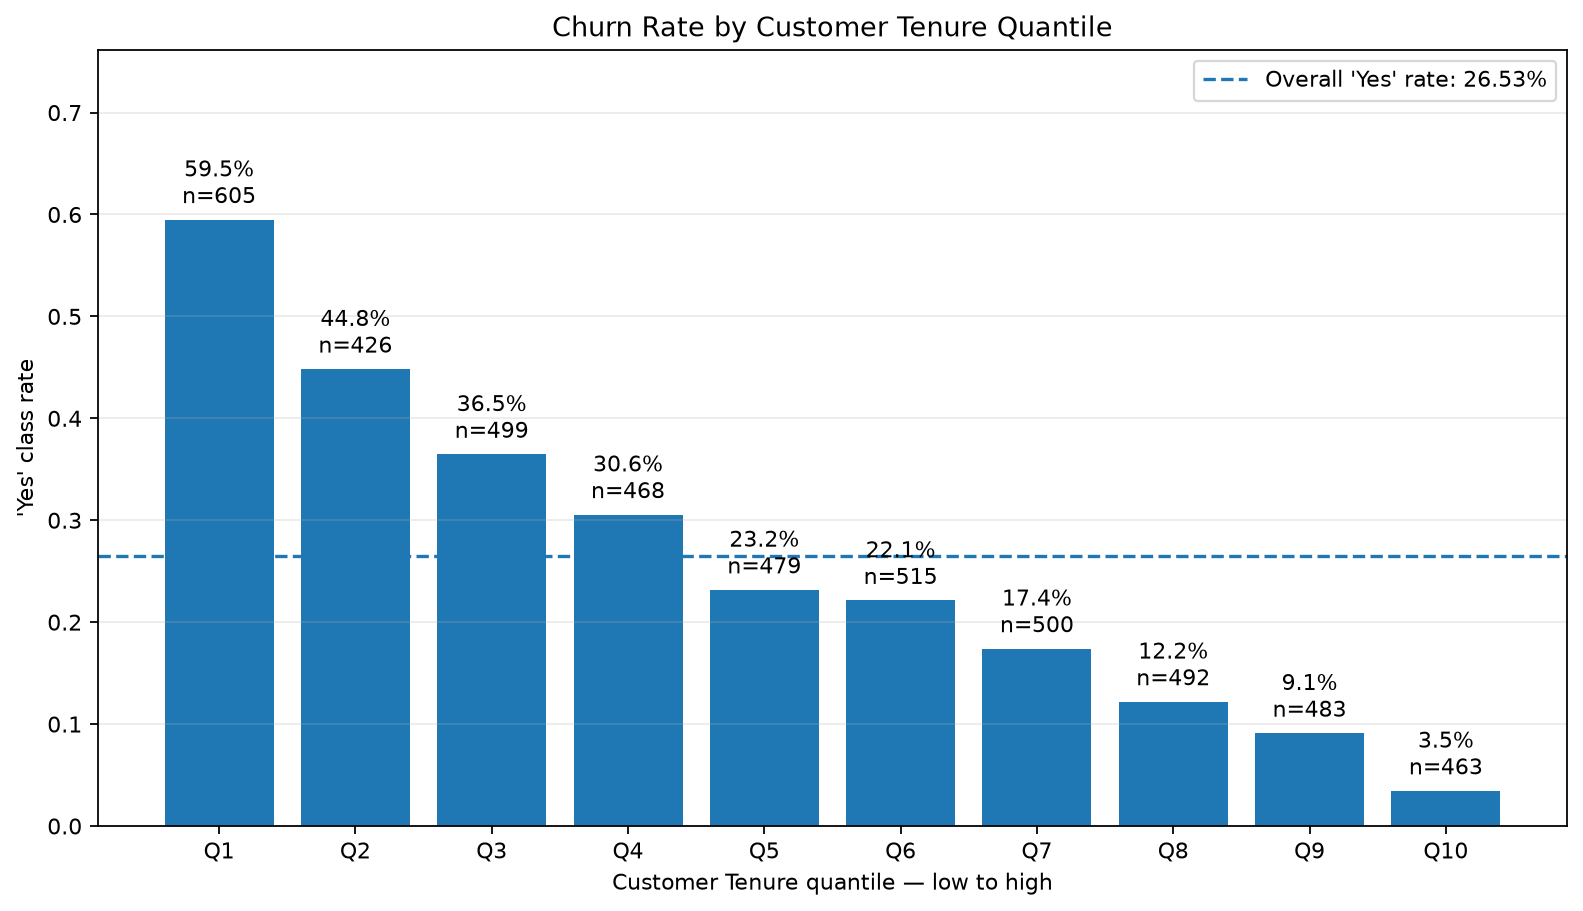
O tempo de permanência contém sinal preditivo relevante, mas também está mecanicamente relacionado ao período durante o qual a conta já permaneceu ativa. Portanto, essa associação não deve ser interpretada como evidência de um efeito causal de retenção.
Tipo de contrato, suporte técnico, segurança online, serviço de internet e forma de pagamento estão entre as associações categóricas mais fortes com churn.
No conjunto de treino, as maiores associações categóricas incluem Contract (Cramér’s V 0,417), TechSupport (0,345), OnlineSecurity (0,340), InternetService (0,315) e PaymentMethod (0,308).
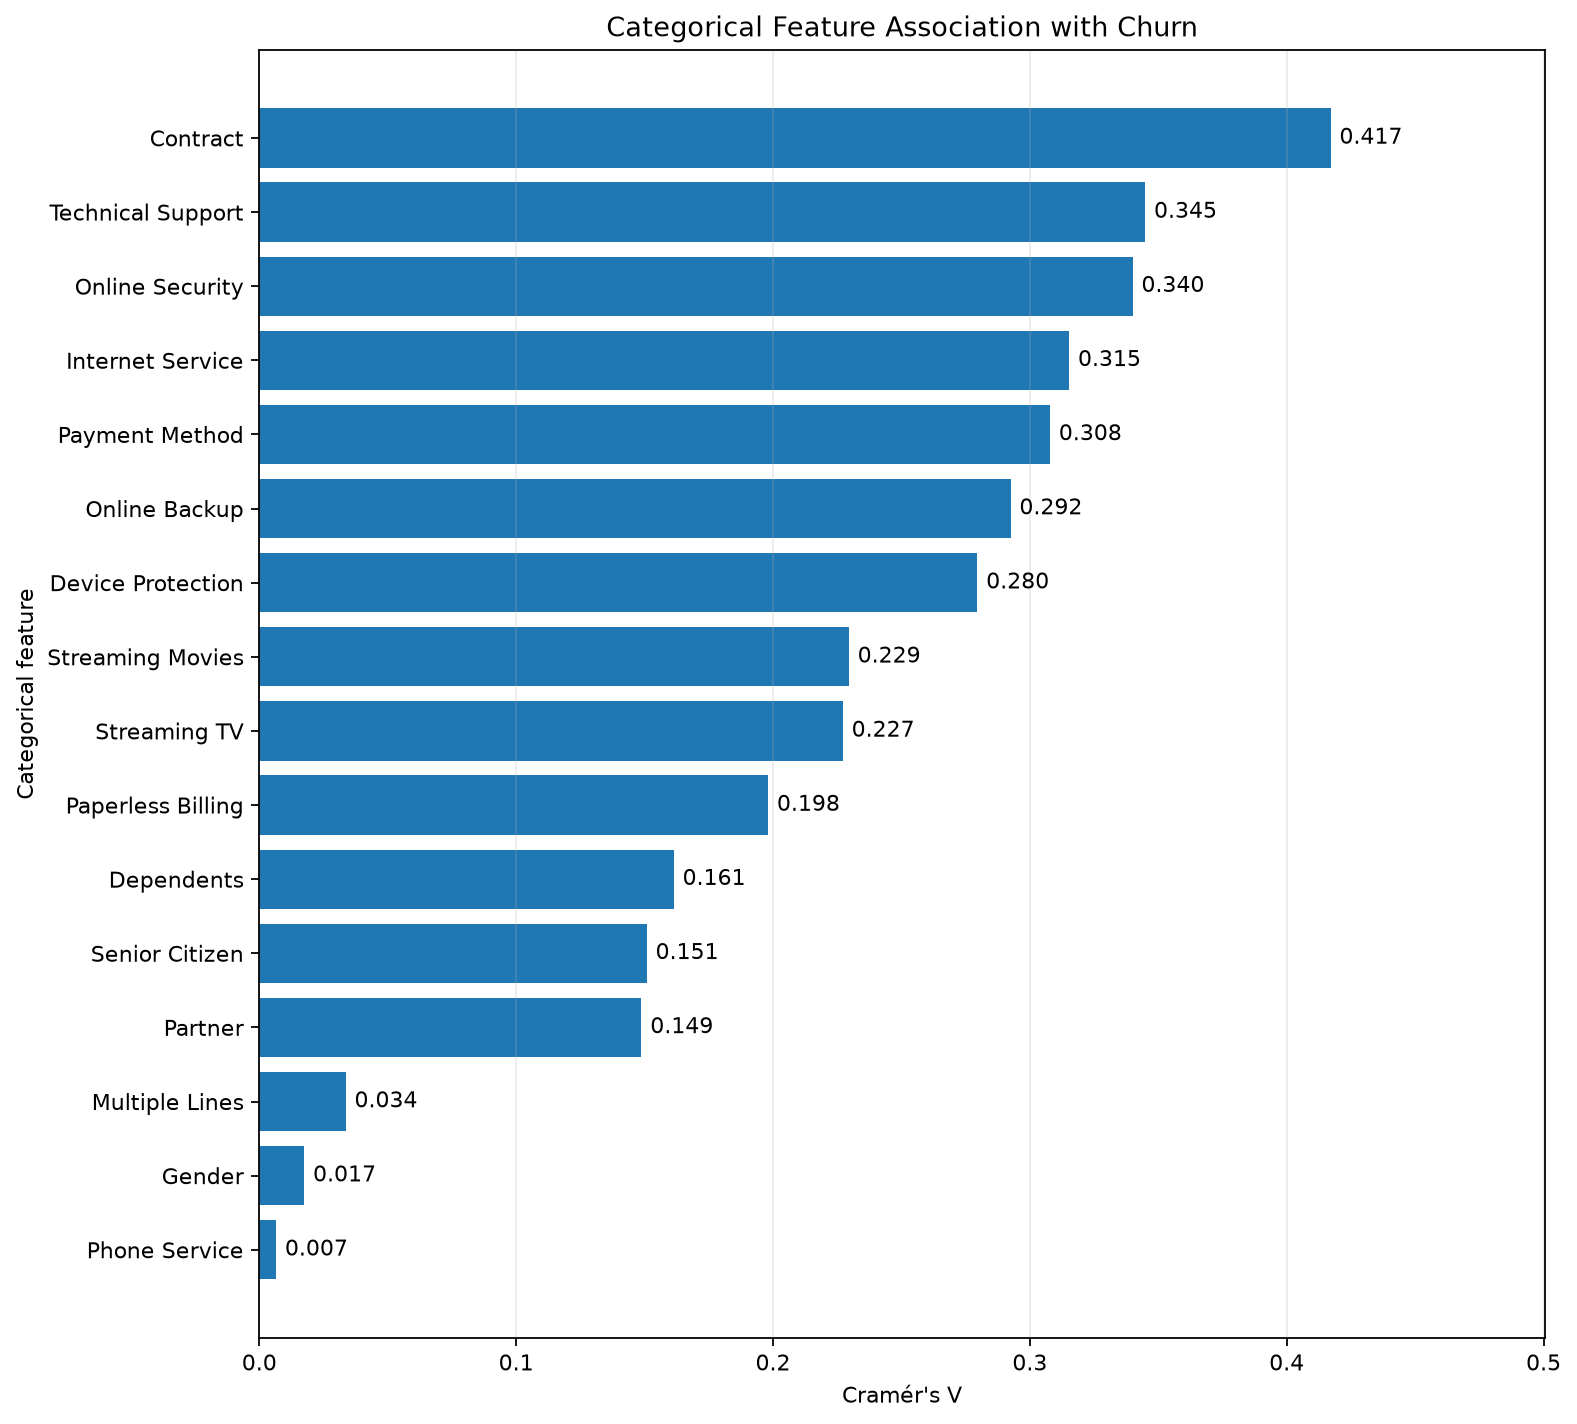
Essas relações foram utilizadas apenas como evidência exploratória. O ranking não foi empregado para selecionar features: todas as 19 variáveis previstas pelo contrato científico foram mantidas na modelagem.
03 — Modelagem e resultado
O estudo compara um baseline Dummy baseado apenas na prevalência das classes com Regressão Logística, Decision Tree, Random Forest e HistGradientBoostingClassifier.
Como Churn = Yes corresponde a aproximadamente 26,5% das observações, Average Precision é utilizada como métrica principal de seleção. Os modelos candidatos passam por busca de hiperparâmetros com validação cruzada estratificada de cinco folds sobre a partição de treino e, posteriormente, por uma única avaliação na validação.
A política de busca avalia 24 configurações para Logistic Regression, 48 para Decision Tree, 40 para Random Forest e 40 para HistGradientBoosting, totalizando 152 configurações candidatas entre as quatro famílias pesquisadas.
Um candidato somente é considerado elegível quando sua Average Precision na validação supera o baseline Dummy por mais de 0,01.
HistGradientBoosting, Regressão Logística e Random Forest formam um practical tie entre três modelos segundo a regra previamente definida pelo estudo: além de permanecerem a até 0,01 do líder em Average Precision na validação, seus intervalos aproximados de desempenho em cross-validation atendem ao critério de sobreposição definido no protocolo.
O desempate é resolvido pelo primeiro critério estabelecido no protocolo: menor Brier score na validação. O HistGradientBoosting apresenta Brier score de 0,133203, contra 0,133898 da Regressão Logística e 0,159317 da Random Forest.
Esse critério seleciona o HistGradientBoostingClassifier como modelo final.
A configuração científica selecionada utiliza:
learning_rate = 0.03max_iter = 200max_depth = 3max_leaf_nodes = 7min_samples_leaf = 40l2_regularization = 1.0
Depois que modelo e threshold são congelados, o pipeline selecionado é ajustado sobre treino + validação, totalizando 5.986 observações, e avaliado uma única vez no conjunto de teste reservado de 1.057 contas.
Os resultados científicos finais são:
Average Precision — 0,6413
ROC-AUC — 0,8402
Brier score — 0,1394
Log loss — 0,4207
Os resultados mostram que as características disponíveis das contas contêm sinal preditivo útil para ordenar contas associadas a maior ou menor probabilidade de churn dentro do protocolo de avaliação utilizado.
O estudo também seleciona, exclusivamente sobre a validação, um threshold educacional de aproximadamente 0,2578, definido para maximizar precision mantendo recall de pelo menos 80%. Esse valor é parte da análise científica e não representa um threshold operacional ou economicamente otimizado para retenção de clientes.
04 — Principais conclusões e limitações
O estudo mostra que informações já disponíveis sobre a conta do cliente — principalmente tipo de contrato, tempo de permanência, características de serviços e suporte, faturamento e valores cobrados — contêm informação relevante para classificação de churn.
A comparação entre modelos também mostra que a conclusão científica não deve ser reduzida simplesmente à ideia de que um algoritmo foi muito superior aos demais. HistGradientBoosting, Regressão Logística e Random Forest ficaram suficientemente próximos para formar um practical tie segundo o protocolo previamente definido, e o HistGradientBoosting foi selecionado pelo critério de desempate baseado em Brier score.
O resultado, porém, deve ser interpretado dentro dos limites do experimento. A avaliação utiliza uma divisão aleatória estratificada do snapshot, e não um holdout temporal ou prospectivo. Portanto, a capacidade de generalização para períodos futuros não foi estabelecida. A representatividade externa e a estabilidade da distribuição dos dados ao longo do tempo também não foram demonstradas.
As associações exploratórias não representam efeitos causais, e o estudo não demonstra que alterar contrato, serviço ou característica de um cliente reduziria o churn.
O estudo também não define uma política de retenção para produção nem um threshold de decisão economicamente otimizado. O threshold escolhido na validação tem finalidade explicitamente educacional e não representa uma regra operacional de negócio.
Uma versão anterior do estudo realizou análise exploratória dependente do target sobre o dataset completo antes da definição do protocolo atual de holdout. O fluxo atual mantém o teste procedimentalmente isolado e não utiliza essas linhas nas decisões atuais de seleção, mas elas não podem ser descritas como dados nunca vistos anteriormente pelo autor.
Também não foram estabelecidas validade temporal prospectiva, representatividade externa, estabilidade futura da distribuição, fairness entre subgrupos, eficácia de intervenções de retenção ou segurança para decisões automatizadas.
Este post apresenta os principais resultados científicos. O repositório do estudo contém notebooks, contratos de fonte e ambiente, evidências de seleção de modelos, artefatos de reprodutibilidade e a metodologia detalhada.
O Atlas DataFlow mantém a evidência de reprodução científica separada de sua própria linhagem de treinamento e release Atlas Native. Essa separação preserva a distinção entre os resultados do estudo científico original, sua reprodução independente e as avaliações realizadas sob os contratos próprios do Atlas.