Concrete Compressive Strength
Predição da resistência à compressão do concreto a partir da composição da mistura e da idade de cura.
Modelo selecionado: HistGradientBoostingRegressor
01 — Visão geral
O dataset UCI Concrete Compressive Strength contém 1.030 observações descritas por oito medidas numéricas relacionadas à composição da mistura do concreto e à idade de cura. O target, Concrete compressive strength, é um valor numérico contínuo medido em MPa.
As sete variáveis relacionadas aos componentes da mistura identificam 427 misturas distintas de concreto. Muitas dessas misturas foram medidas em mais de uma idade de cura: 181 misturas aparecem em múltiplas observações, correspondendo a 784 linhas do dataset.
O estudo investiga se as medidas disponíveis de composição da mistura e idade de cura contêm informação preditiva útil para estimar a resistência à compressão sob um protocolo de avaliação reproduzível realizado por linha.
A análise é preditiva, e não causal. As relações entre ingredientes, idade de cura e resistência descrevem padrões estatísticos observados nos dados e não estabelecem o efeito de alterar individualmente um componente da mistura.
Todas as 1.030 observações disponibilizadas e as oito variáveis validadas foram preservadas. Não foi aplicada remoção genérica de outliers, transformação do target ou deduplicação sem suporte documental.
Um split reproduzível, embaralhado e realizado por linha na proporção 70/15/15 produziu 721 observações de treino, 154 de validação e uma partição final de teste com 155 observações. O teste final permaneceu fora da seleção de modelos e das decisões de hiperparâmetros.
Como o split ocorre por linha e não agrupa observações pela composição da mistura, medições em diferentes idades de uma mesma mistura podem aparecer em partições distintas. Essa característica é importante para interpretar corretamente o desempenho final.
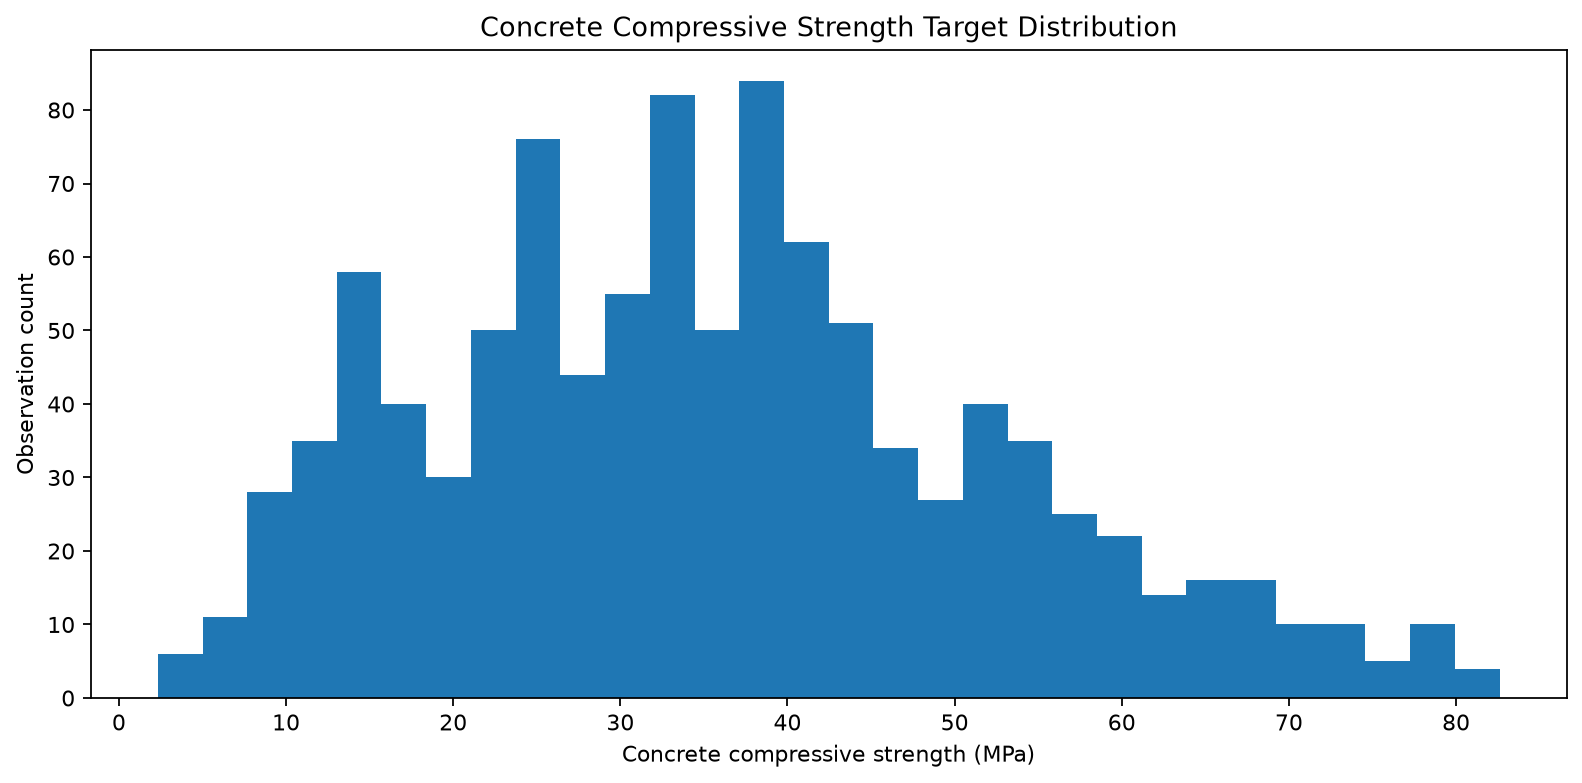
O target abrange uma ampla faixa de valores observados de resistência à compressão e permanece em sua escala original de MPa durante todo o estudo. Valores extremos são tratados como observações descritivas, e não como candidatos automáticos à remoção.
02 — O que os dados revelaram
A análise exploratória identificou relações mensuráveis entre diversas variáveis e a resistência à compressão.
Idade e cimento apresentam associações univariadas positivas de destaque com o target, o superplastificante também apresenta sinal positivo, enquanto a água apresenta associação negativa.
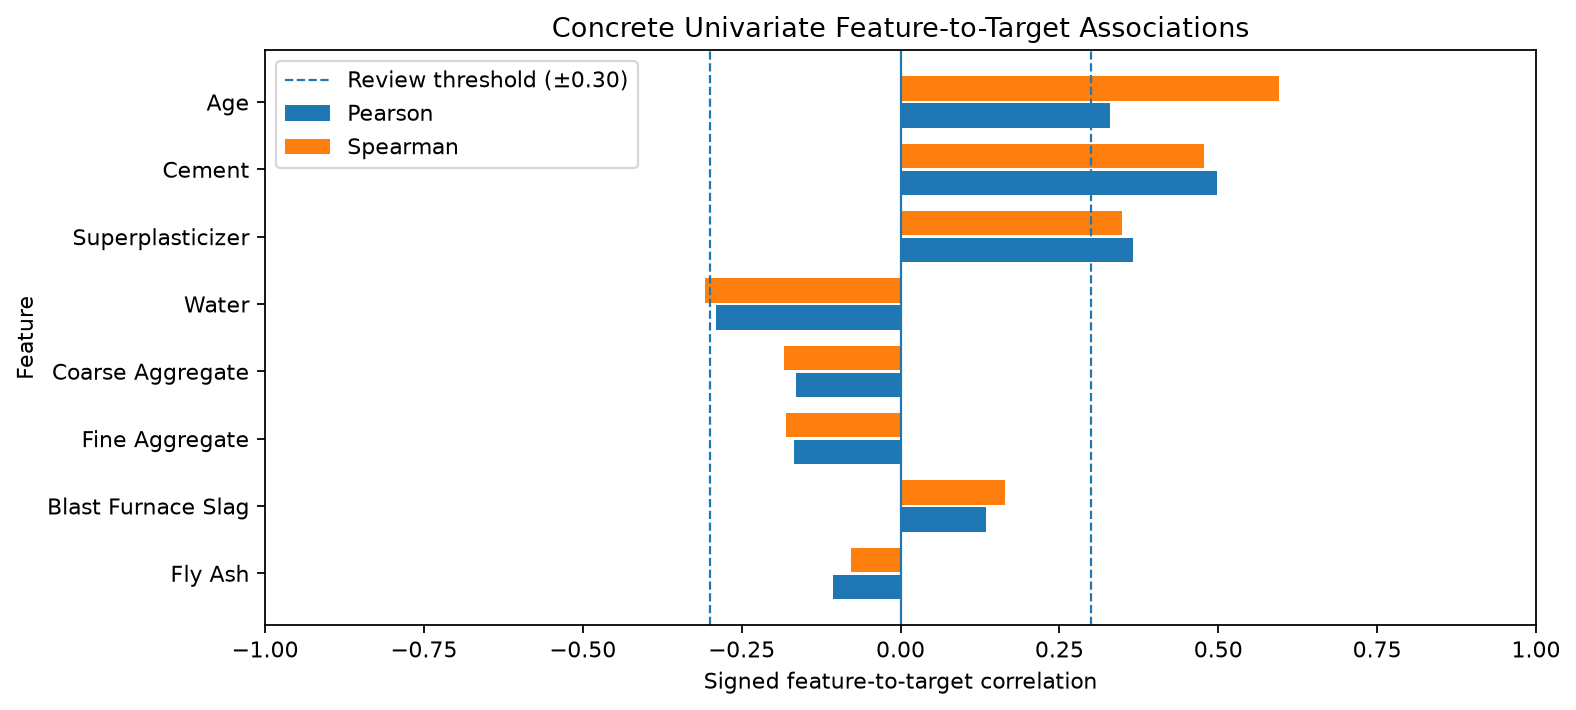
Idade e cimento apresentam associações univariadas positivas de destaque com a resistência à compressão, enquanto a água apresenta associação negativa. As estimativas de Pearson e Spearman são utilizadas como sinais descritivos, e não como efeitos causais.
O espaço numérico das variáveis também apresenta dependência relevante entre alguns componentes da mistura.
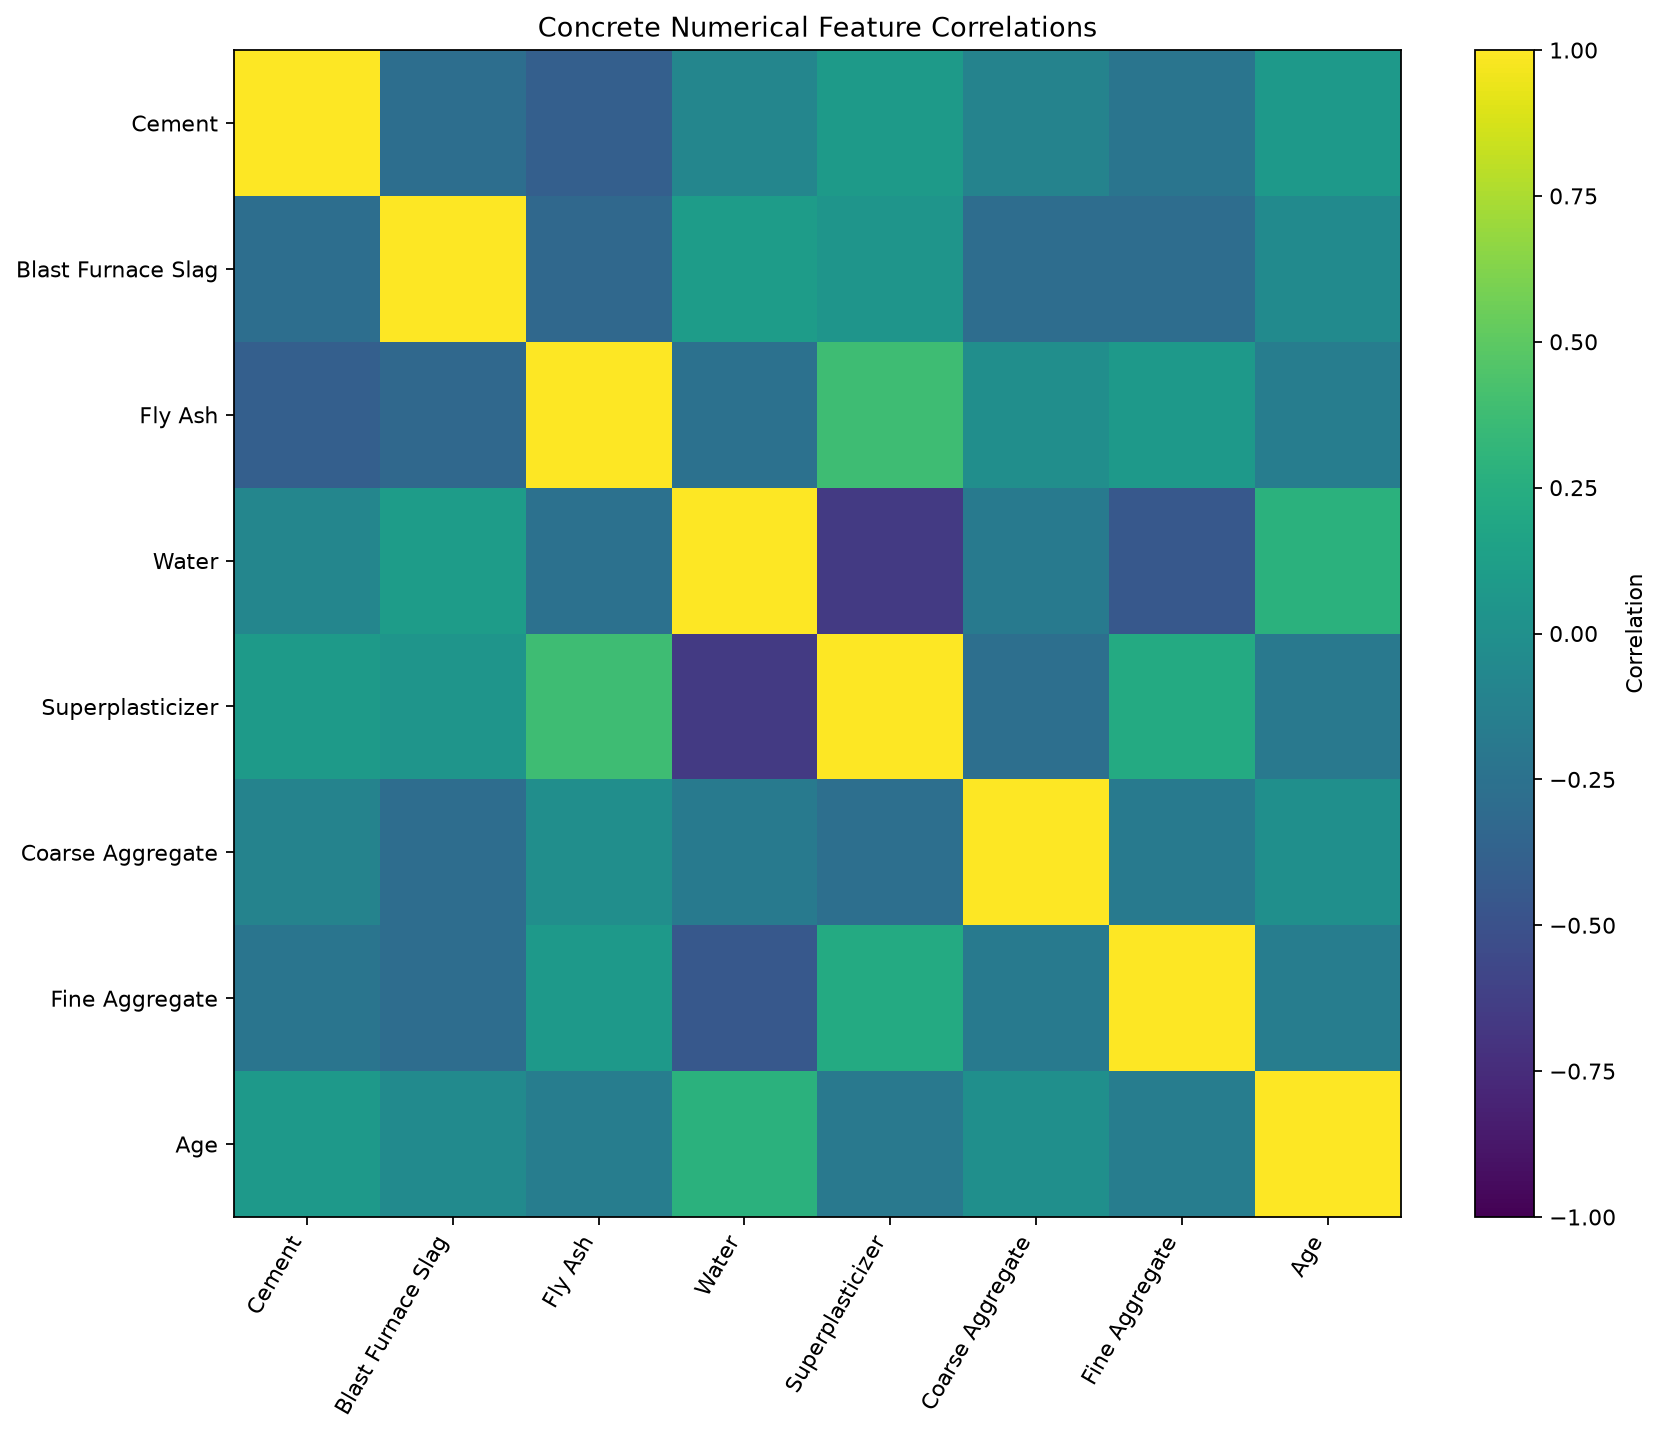
O mapa de correlação mostra que diversos componentes da mistura apresentam dependência estatística. O estudo preserva essa estrutura em vez de remover automaticamente variáveis correlacionadas.
A análise exploratória também encontra evidências de que uma relação puramente linear e aditiva pode não representar toda a estrutura preditiva disponível.
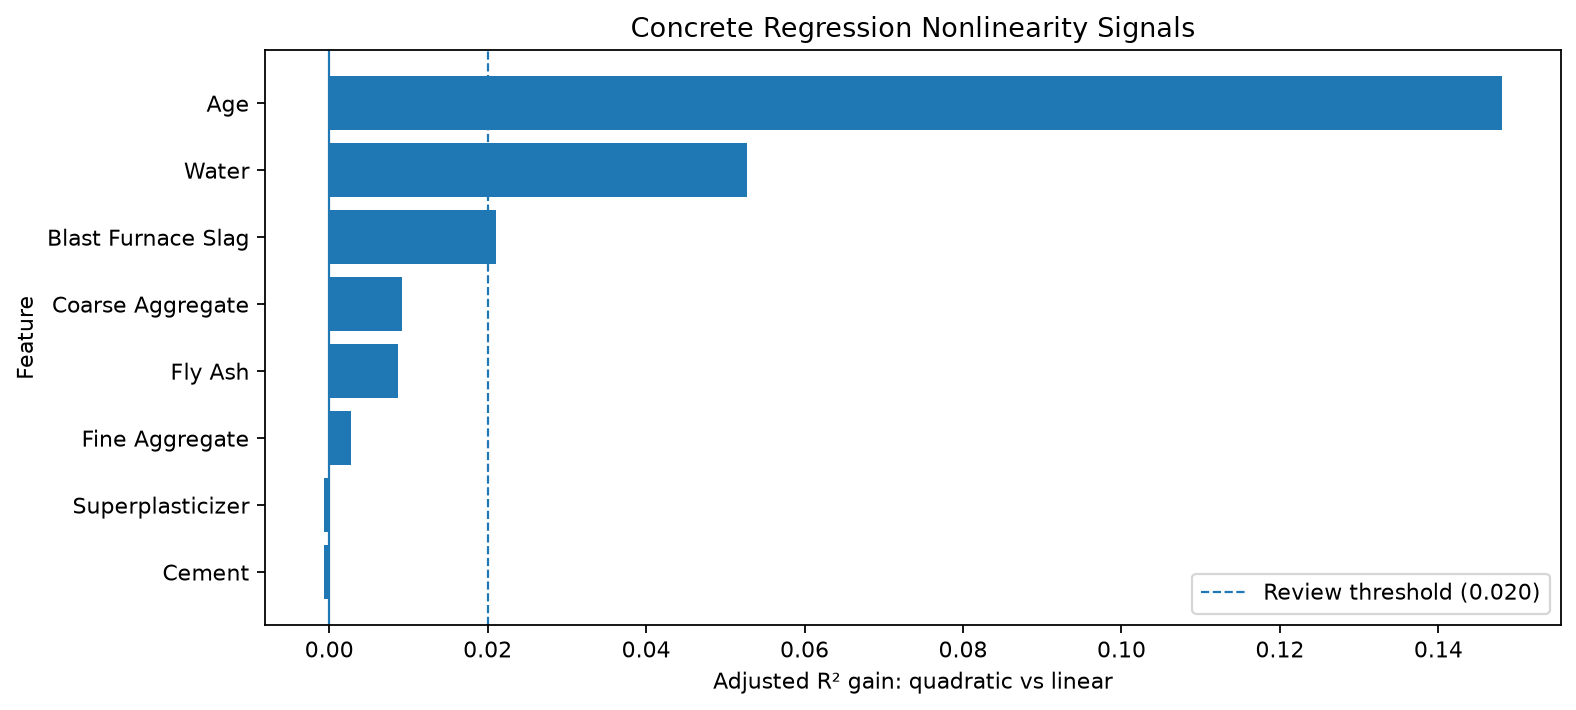
Idade, água e escória de alto-forno ultrapassam o limiar exploratório de revisão de não linearidade do estudo, motivando a comparação com famílias de modelos não lineares mais flexíveis.
Também são observados sinais potenciais de interação entre alguns pares de variáveis.
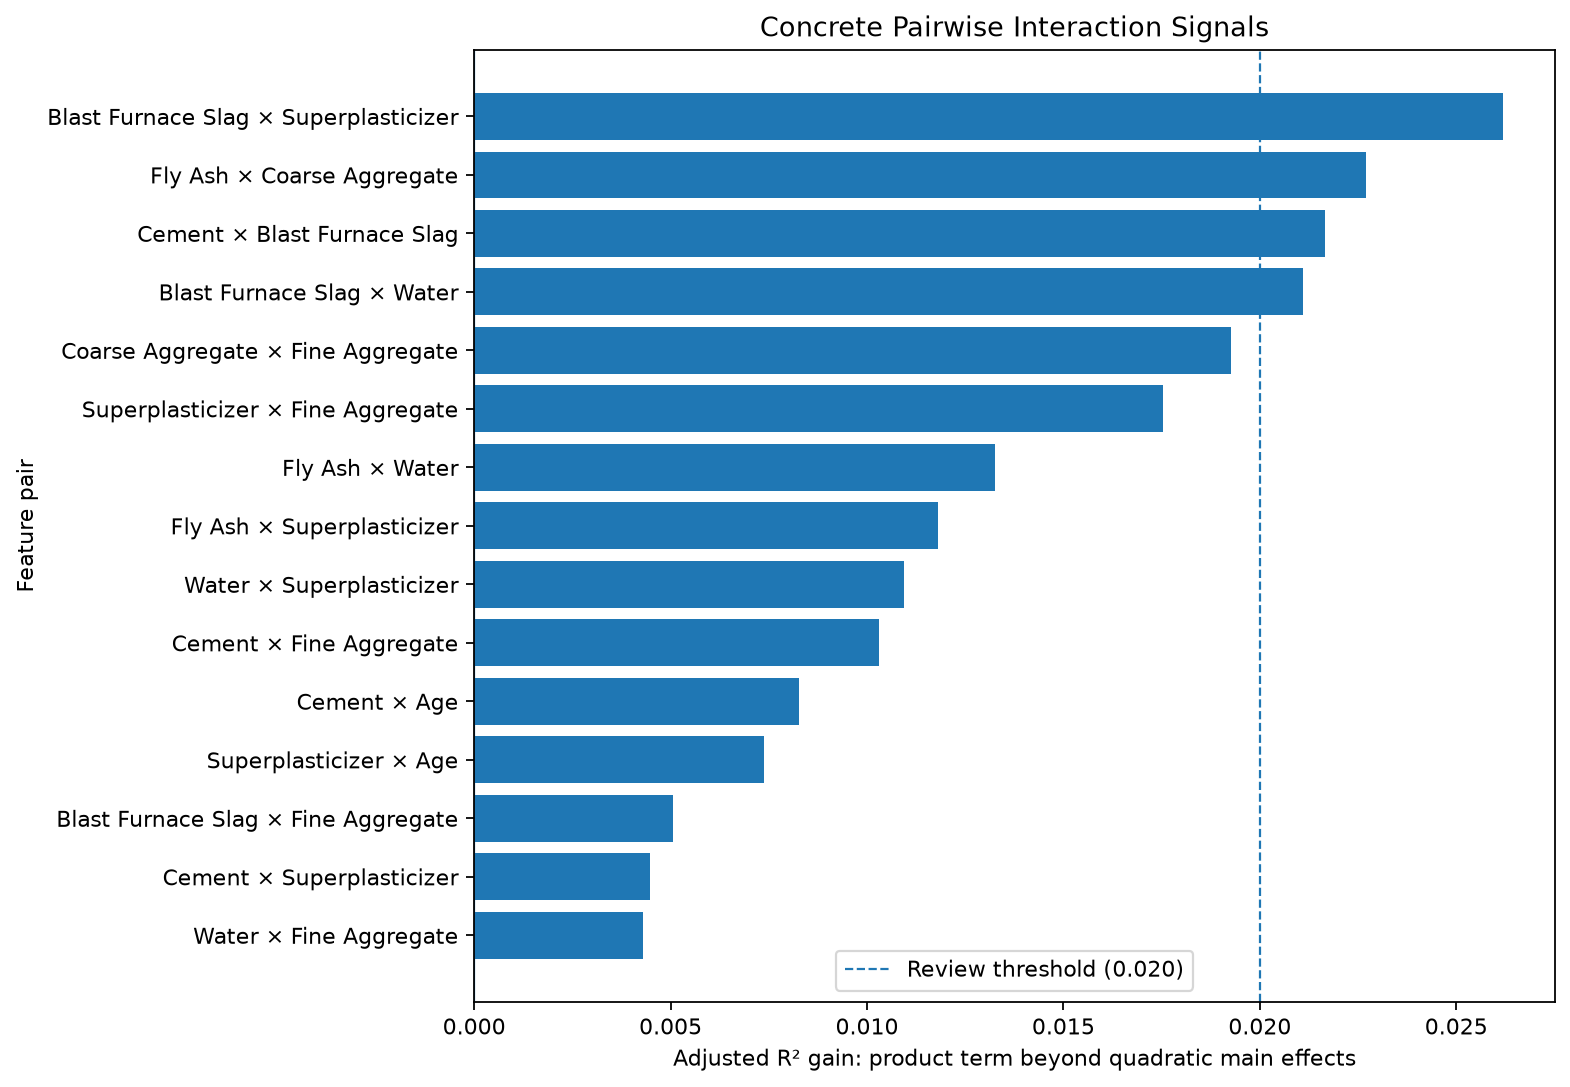
Entre os sinais exploratórios de interação mais fortes estão Blast Furnace Slag × Superplasticizer, Fly Ash × Coarse Aggregate, Cement × Blast Furnace Slag e Blast Furnace Slag × Water. Esses diagnósticos motivam modelos capazes de representar interações, mas não constituem por si só evidência de desempenho.
Essas evidências são exploratórias e observadas dentro da própria amostra. Elas motivam a comparação de modelos, mas não devem ser interpretadas como efeitos independentes das features nem como evidência de que alterar um ingrediente específico causaria a diferença observada na resistência.
03 — Modelagem e resultado
O estudo comparou um baseline Dummy baseado na mediana com Ridge, Decision Tree, Random Forest e HistGradientBoosting para regressão.
As quatro famílias treináveis avaliaram 52 configurações de hiperparâmetros utilizando validação cruzada em cinco folds restrita à partição de treino.
MAE foi utilizada como métrica principal de seleção porque expressa o erro de previsão diretamente em MPa.
O HistGradientBoostingRegressor apresentou o melhor resultado na validação congelada:
- HistGradientBoostingRegressor — MAE 2,7417 MPa
- Random Forest — MAE 3,7689 MPa
- Decision Tree — MAE 4,2860 MPa
- Ridge — MAE 8,5944 MPa
- Baseline Dummy mediana — MAE 12,8145 MPa
O modelo selecionado ficou mais de 0,10 MPa à frente do segundo melhor candidato, ultrapassando a tolerância predefinida para empate prático. Por isso, não foi necessário aplicar os critérios de desempate.
Depois que família de modelo, hiperparâmetros, política de features e decisões de pré-processamento foram congelados, o HistGradientBoostingRegressor foi treinado uma única vez sobre treino + validação — 875 observações — e avaliado na partição final de teste com 155 observações.
O resultado agregado do teste final foi:
MAE — 2,5822 MPa
RMSE — 4,2104 MPa
R² — 0,9387
Erro Absoluto Mediano — 1,6363 MPa
Considerando todo o conjunto final de teste, as previsões diferem da resistência observada em aproximadamente 2,58 MPa em média em termos absolutos.
Escopo da avaliação: misturas vistas e não vistas
O resultado agregado exige uma qualificação importante.
Como o split foi realizado por linha, uma observação mantida fora do treinamento pode pertencer a uma composição de concreto que já estava representada durante o fitting em outra idade de cura.
Das 155 observações do teste final:
- 116 linhas — 74,84% — pertencem a misturas já representadas em treino + validação;
- 39 linhas — 25,16% — pertencem a composições de mistura que não estavam representadas durante o fitting.
Os resultados desses dois grupos são materialmente diferentes:
| Subconjunto de avaliação | Observações | MAE | RMSE | R² |
|---|---|---|---|---|
| Mistura vista durante o fitting | 116 | 2,1978 MPa | 2,9552 MPa | 0,9699 |
| Mistura não vista durante o fitting | 39 | 3,7255 MPa | 6,6694 MPa | 0,8416 |
| Teste final completo | 155 | 2,5822 MPa | 4,2104 MPa | 0,9387 |
As métricas principais do teste final são, portanto, dominadas por observações cuja composição da mistura já estava representada durante o fitting.
O subconjunto de misturas não vistas também é pequeno, com apenas 39 observações. Suas métricas fornecem uma evidência diagnóstica relevante, mas não são suficientes para estabelecer de maneira robusta a generalização para composições de concreto genuinamente novas.
04 — Principais conclusões e limitações
O estudo demonstra que as medidas disponíveis de composição da mistura e idade de cura contêm forte informação preditiva para estimar a resistência à compressão sob o protocolo de avaliação por linha executado.
As evidências exploratórias ajudam a explicar por que modelos não lineares deveriam ser avaliados: os dados apresentam dependência entre variáveis, sinais mensuráveis de não linearidade e possíveis interações. De forma coerente com essa hipótese, HistGradientBoosting superou substancialmente o benchmark linear aditivo Ridge durante a validação congelada.
O MAE de 2,5822 MPa no teste final permanece amplamente consistente com a validação, mas sua interpretação precisa respeitar a estrutura do dataset.
A maior parte das observações do teste final pertence a composições de mistura já representadas durante o fitting. Nesse grupo, o MAE é de aproximadamente 2,20 MPa. Nas 39 observações pertencentes a misturas não vistas durante o fitting, o MAE aumenta para aproximadamente 3,73 MPa.
O estudo, portanto, sustenta desempenho preditivo dentro do desenho de avaliação por linha observado, especialmente para composições de mistura representadas durante o fitting.
Ele não estabelece desempenho equivalente para composições de concreto genuinamente novas. Uma conclusão mais forte nesse sentido exigiria uma avaliação separada agrupada por composição de mistura, além de um novo holdout não utilizado anteriormente.
Outras limitações permanecem relevantes:
- a avaliação utiliza um snapshot aleatório embaralhado, e não validação prospectiva ou externa;
- o subconjunto de teste com misturas não vistas contém somente 39 observações;
- não foi estabelecida representatividade externa para materiais, laboratórios, normas de ensaio ou condições ambientais diferentes;
- o estudo não produz intervalos individuais de incerteza das previsões;
- erros de medição nas variáveis de origem não são modelados;
- não são estimados efeitos causais da alteração dos componentes da mistura ou da idade de cura;
- disponibilidade operacional das features, monitoramento, tratamento de drift e validade em produção permanecem não confirmados.
O modelo deve, portanto, ser entendido como um estudo preditivo reproduzível, e não como um estimador de resistência de engenharia pronto para produção.
Este post apresenta os principais resultados científicos e seu escopo atual. Os notebooks completos, código, decisões metodológicas, figuras, evidências da seleção de modelos, artefatos de reprodutibilidade e diagnósticos detalhados permanecem disponíveis no repositório do estudo.