Dry Bean
Classificação de sete variedades de feijão seco a partir de medidas numéricas de morfologia.
Modelo selecionado: HistGradientBoostingClassifier
01 — Visão geral
O dataset Dry Bean contém 13.611 grãos de feijão representados por 16 medidas numéricas de morfologia derivadas de análise de imagens. O target, Class, identifica uma entre sete variedades nominais: SEKER, BARBUNYA, BOMBAY, CALI, DERMASON, HOROZ ou SIRA.
O estudo investiga até que ponto essas medidas permitem distinguir amostras de feijão mantidas fora do desenvolvimento sob um protocolo de avaliação previamente definido. O modelo utiliza features numéricas que já foram extraídas das imagens; ele não classifica fotografias brutas. O objetivo é preditivo, e não causal.
Todas as observações da fonte e as 16 features candidatas foram preservadas. Não houve imputação genérica, remoção automática de outliers ou deduplicação sem suporte da fonte.
Os dados foram divididos por um split estratificado 70/15/15 em dois estágios: o seed 42 separou a partição de treino do holdout temporário, e o seed 43 dividiu esse holdout entre validação e teste final. O resultado foi de 9.527 linhas de treino, 2.042 de validação e 2.042 de teste final.
O split foi congelado antes de qualquer análise exploratória dependente das distribuições ou do target. A exploração utilizada durante o desenvolvimento foi então restrita à partição de treino.
As sete classes possuem suportes diferentes. DERMASON é a classe mais frequente e BOMBAY a menos frequente, com razão entre o maior e o menor suporte de aproximadamente 6,8 nos dados de treino.
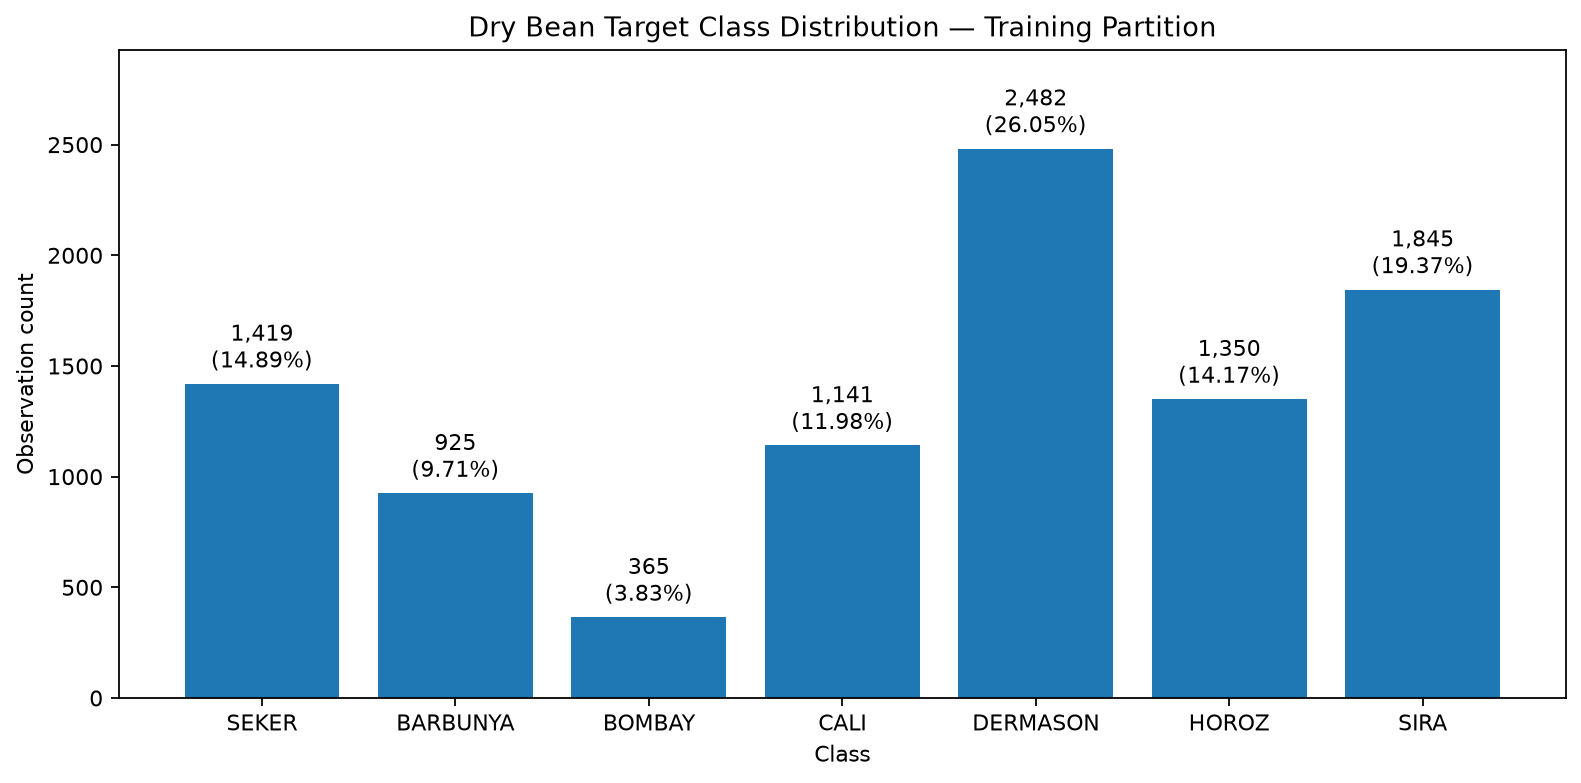
Como os suportes das sete variedades são diferentes, a acurácia global isoladamente não é suficiente para caracterizar o desempenho preditivo. Por esse motivo, Macro F1 é utilizada como métrica principal de seleção, fazendo com que todas as classes contribuam igualmente para o resultado.
02 — O que os dados revelaram
A análise exploratória dependente do target é realizada somente sobre a partição de treino, contendo 9.527 observações.
Diversas medidas de morfologia apresentam associação substancial com Class. Variáveis relacionadas ao tamanho e à geometria do grão — incluindo Area, ConvexArea, EquivDiameter, Perimeter e os comprimentos dos eixos principal e secundário — apresentam sinal preditivo univariado particularmente forte.
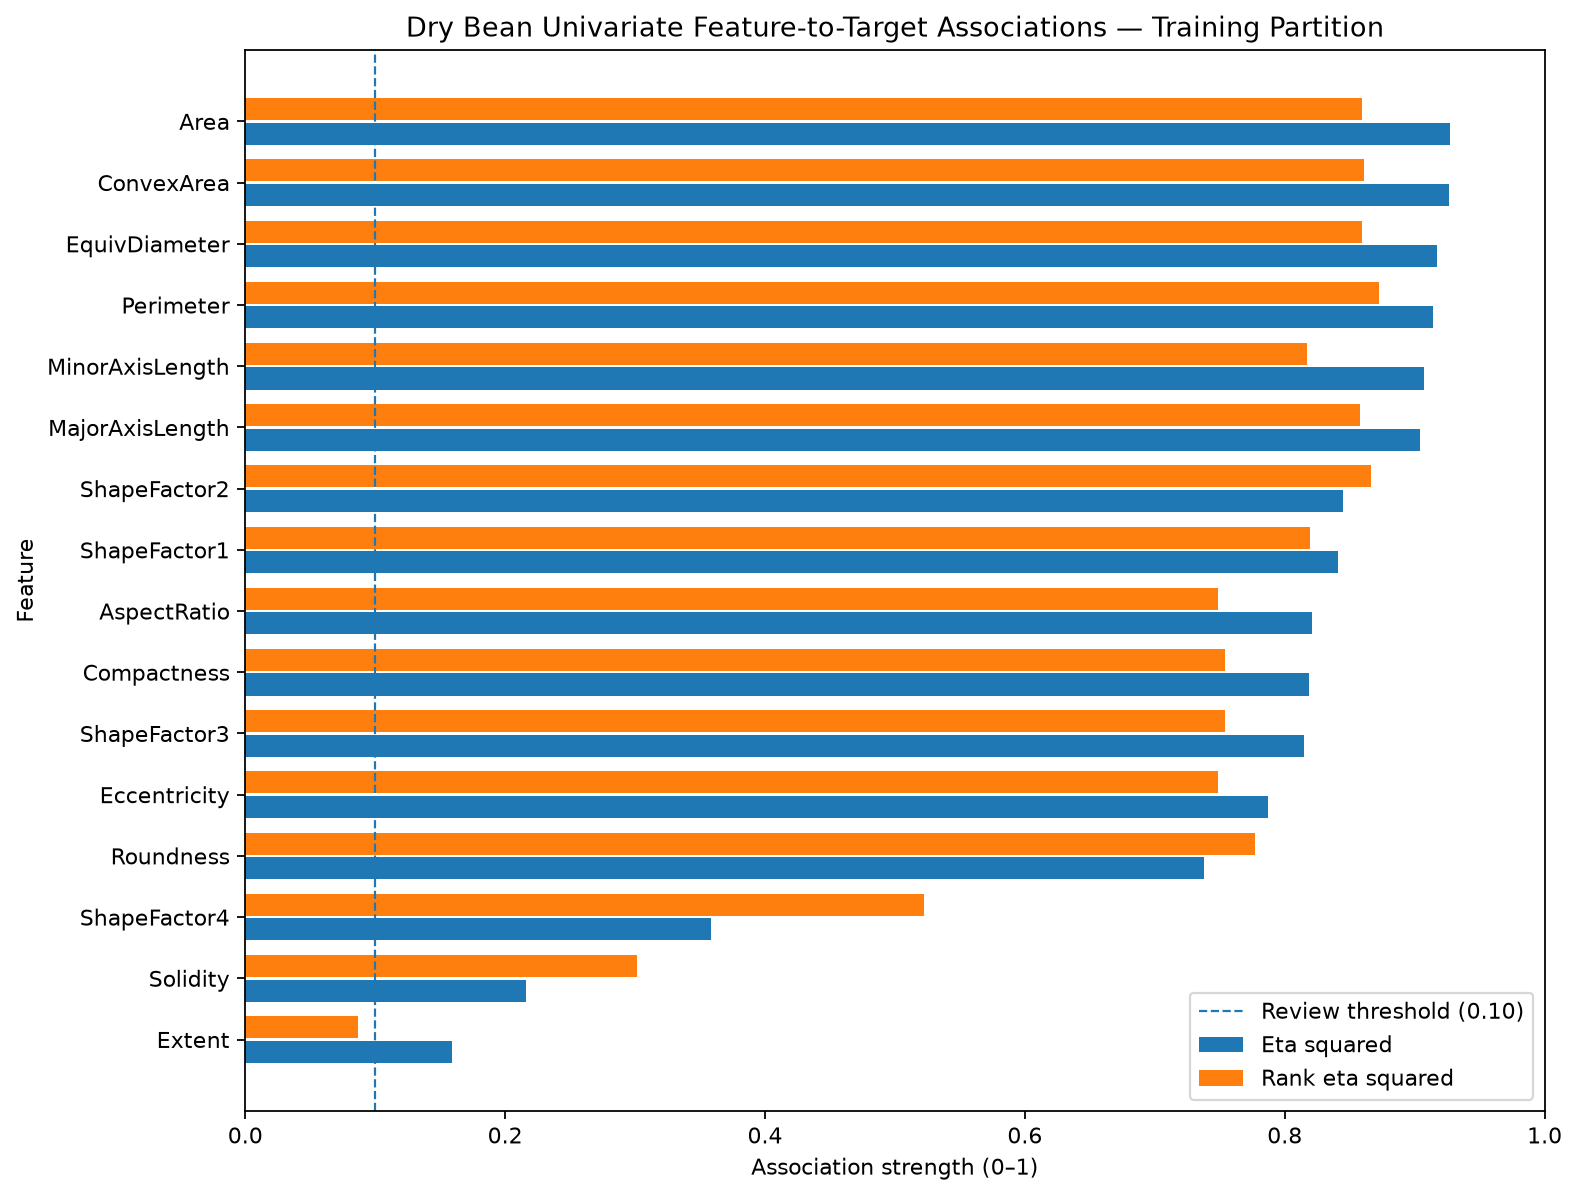
Essas relações constituem evidência exploratória, e não efeitos causais. Elas mostram que a morfologia observada contém informação associada à variedade, mas não demonstram que uma medida individual determine independentemente a classe.
O espaço numérico de features também apresenta redundância substancial. Diversas medidas são fortemente correlacionadas ou matematicamente relacionadas.
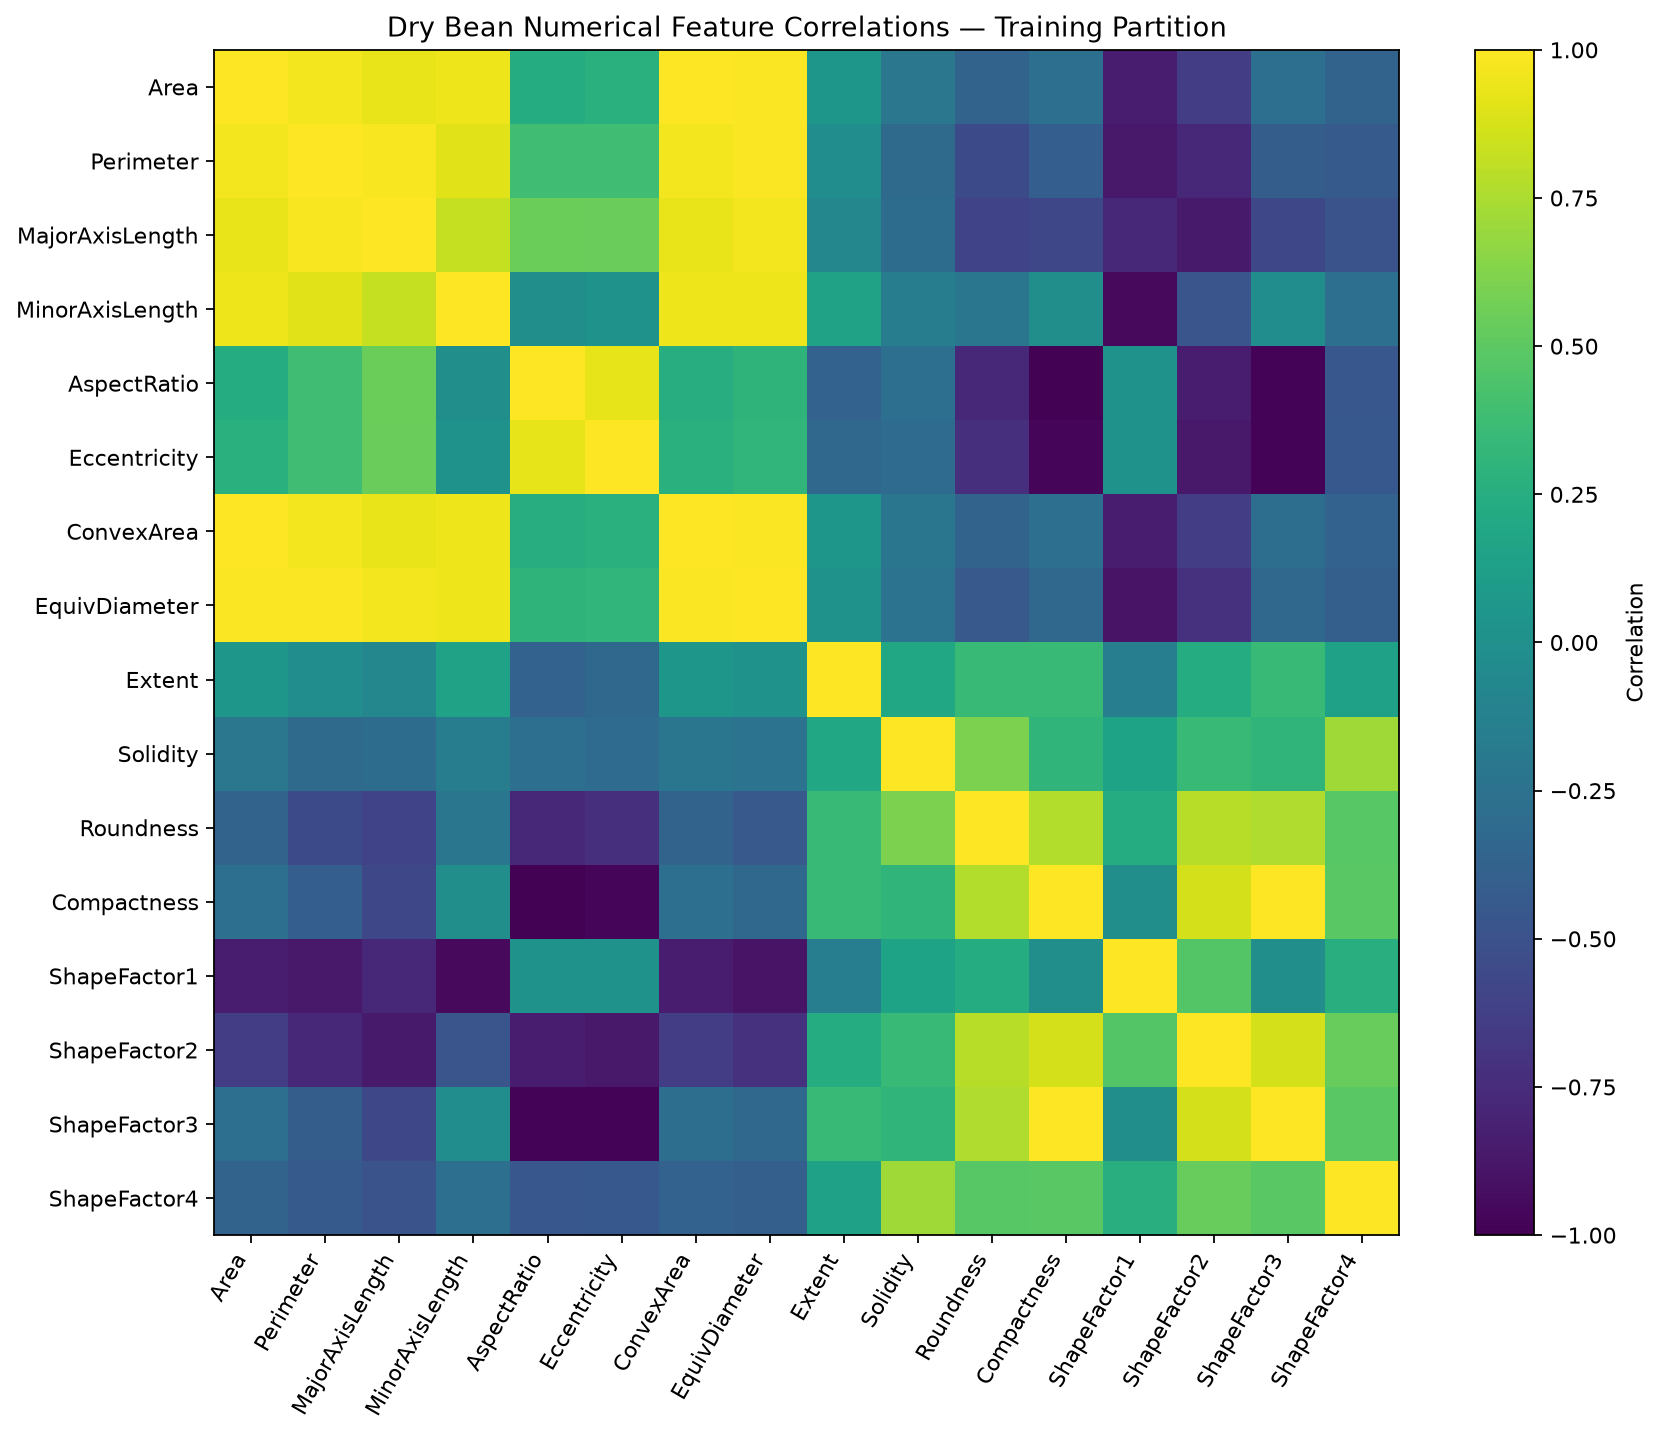
Nove dependências derivadas são numericamente confirmadas:
AspectRatio, Eccentricity, EquivDiameter, Solidity, Roundness, Compactness, ShapeFactor1, ShapeFactor3 e ShapeFactor4.
ShapeFactor2 é tratada separadamente porque sua fórmula de origem auditada não é numericamente confirmada dentro da tolerância configurada. Isso não significa que a feature seja inválida.
Uma projeção exploratória em menor dimensionalidade oferece uma síntese visual de como as sete variedades ocupam o espaço morfológico.
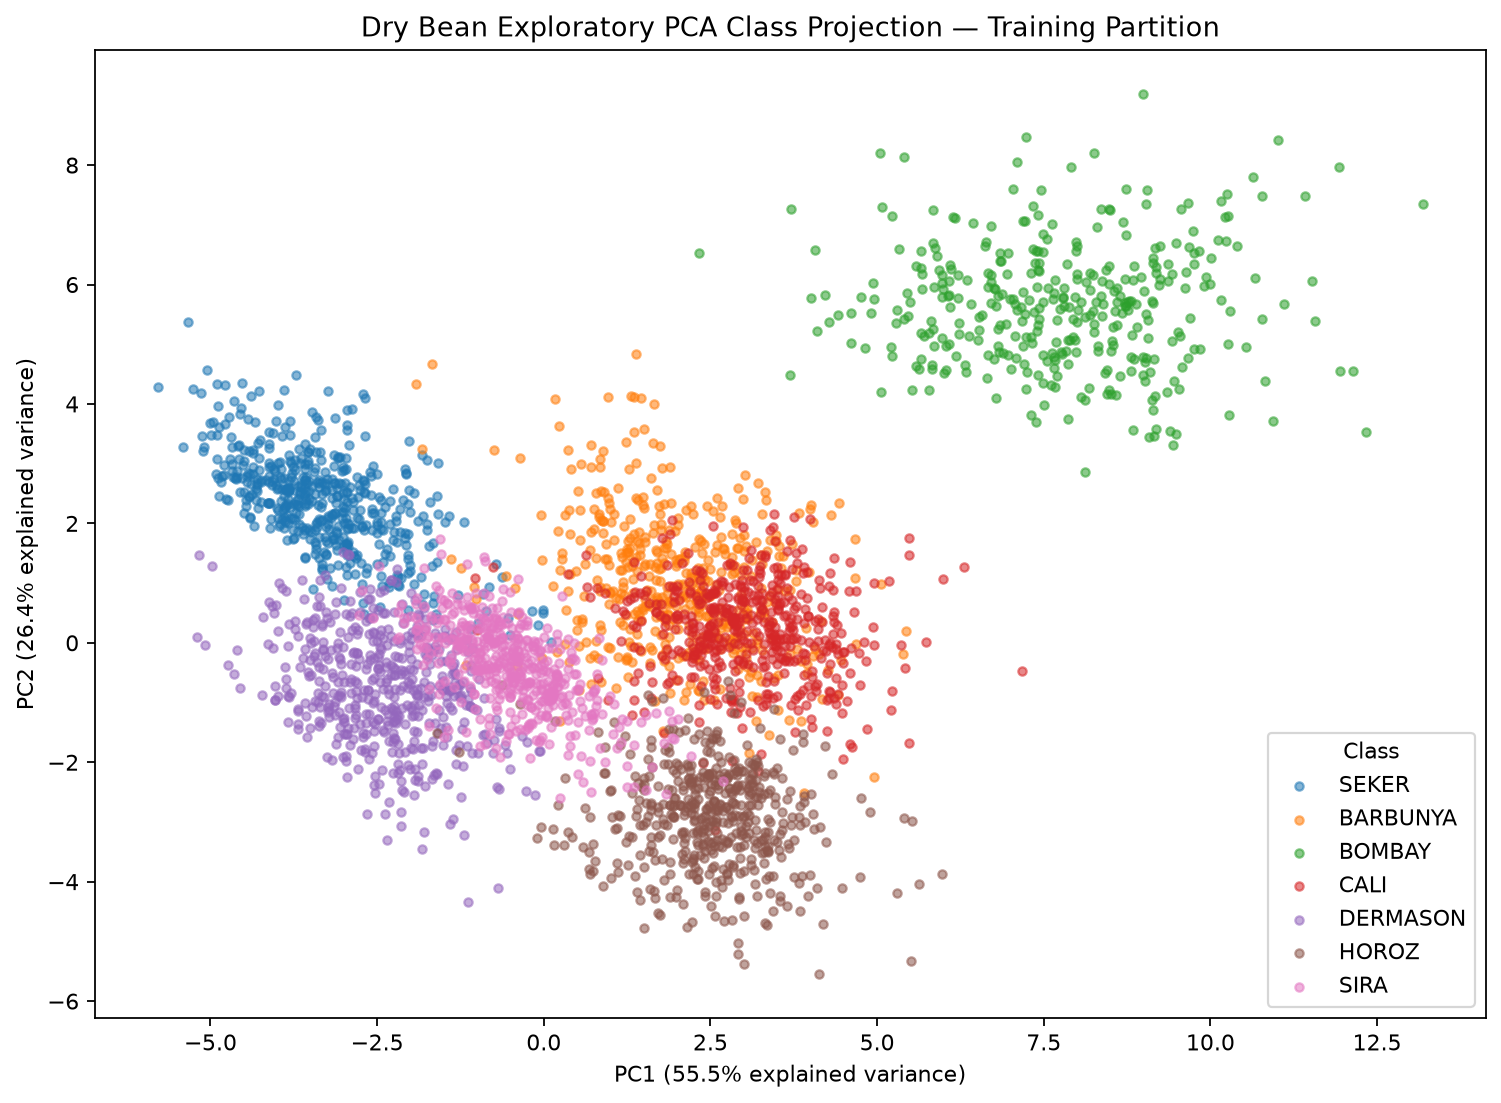
A projeção por PCA mostra separação relevante juntamente com sobreposição entre algumas classes. BOMBAY ocupa uma região comparativamente distinta, enquanto várias outras variedades apresentam sobreposição mais expressiva.
A visualização por PCA é apenas exploratória. Ela não é um classificador e não substitui a representação preditiva completa com 16 features utilizada durante a modelagem.
03 — Modelagem e resultado
O estudo compara um baseline Dummy baseado nas proporções das classes com Logistic Regression, Decision Tree, Random Forest e HistGradientBoostingClassifier.
A busca das famílias candidatas utiliza validação cruzada estratificada em cinco folds restrita à partição de treino.
HistGradientBoostingClassifier apresenta o maior Macro F1 médio em CV, com 0,937012, seguido por Logistic Regression com 0,935031, Random Forest com 0,933343 e Decision Tree com 0,919904.
HistGradientBoostingClassifier e Logistic Regression formam a shortlist definida exclusivamente pela validação cruzada e avançam para a avaliação controlada das políticas de features na partição congelada de validação.
Os modelos selecionados são avaliados sob três políticas de features:
- todas as 16 features;
- todas as features exceto
ShapeFactor2; - sete features após remover as nove features derivadas confirmadas.
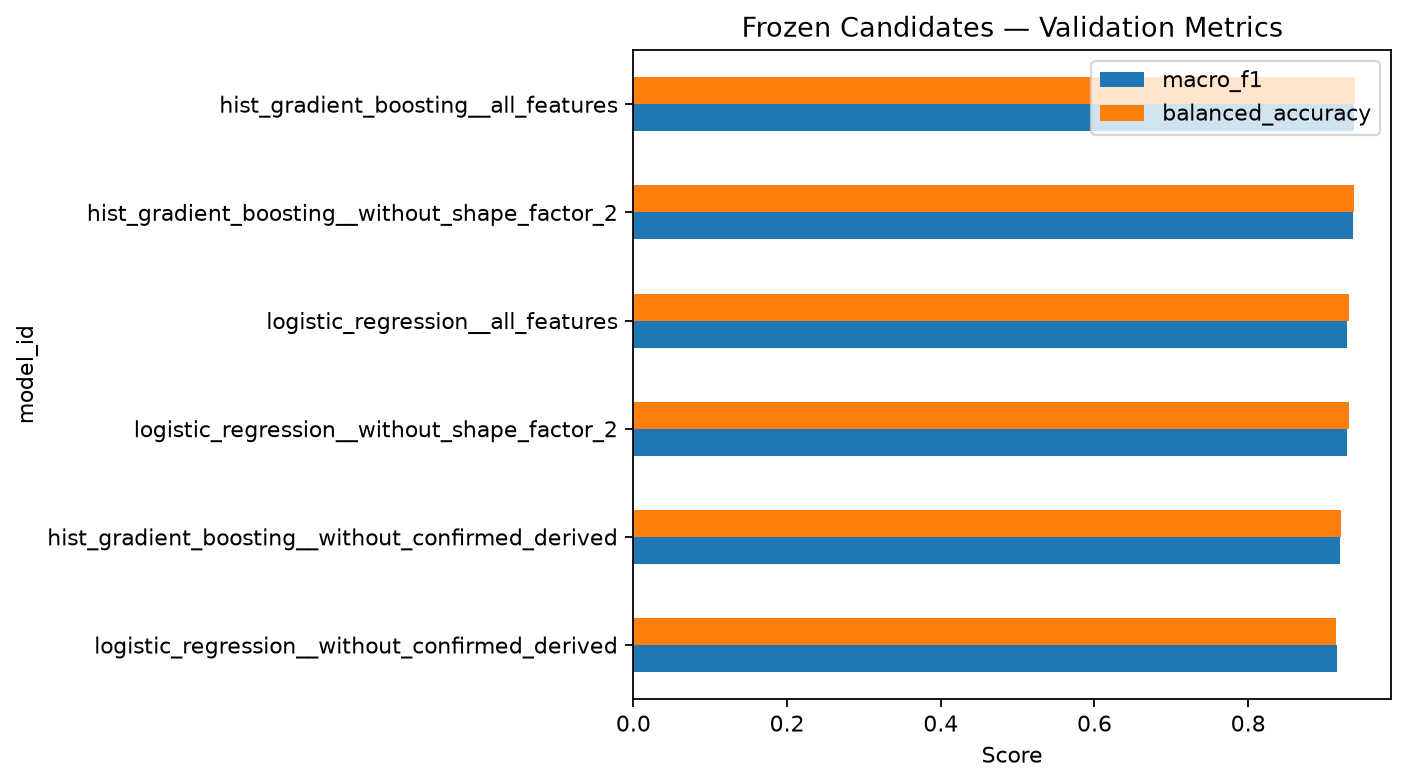
As duas configurações mais fortes de HistGradientBoosting formam um empate prático de validação previamente definido.
Os valores de Macro F1 na validação são:
Todas as features — 0,937881
Sem ShapeFactor2 — 0,936677
A diferença é de aproximadamente 0,001204, inferior à tolerância de empate prático de 0,002.
O empate é, portanto, resolvido pelo primeiro critério predefinido aplicável, a Acurácia Balanceada na validação:
Todas as features — 0,939131
Sem ShapeFactor2 — 0,938146
Isso seleciona hist_gradient_boosting__all_features como a configuração científica final.
O experimento com políticas de features também avalia se a representação morfológica completa deve ser mantida.
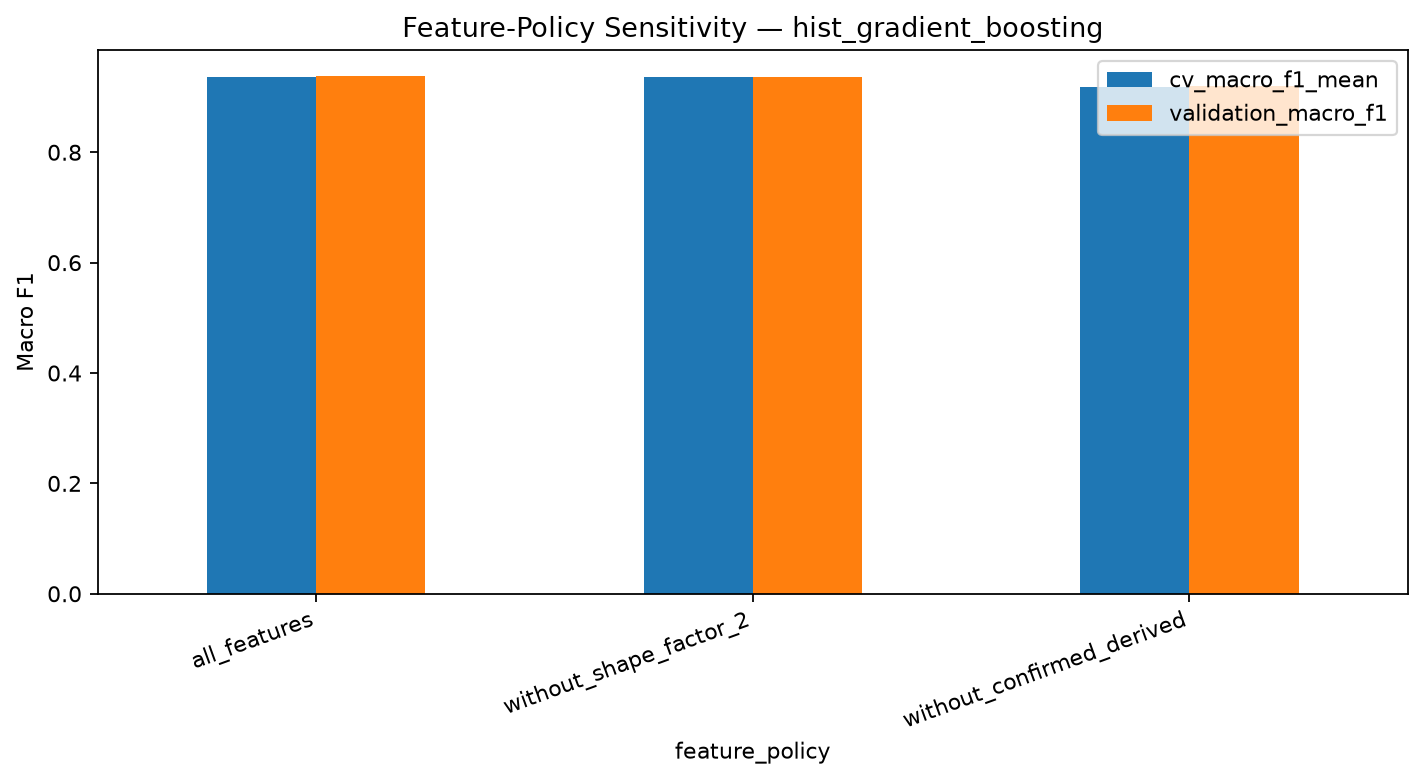
A remoção apenas de ShapeFactor2 altera o Macro F1 de validação em aproximadamente -0,001204.
A remoção das nove features derivadas confirmadas reduz o Macro F1 de validação de aproximadamente 0,937881 para 0,919956, uma diferença de aproximadamente -0,017925.
O HistGradientBoostingClassifier selecionado mantém, portanto, todas as 16 features numéricas, com:
class_weight = Nonelearning_rate = 0.05max_iter = 250max_leaf_nodes = 15min_samples_leaf = 40l2_regularization = 0.0random_state = 42
Nenhum resampling é utilizado.
Depois que a família do modelo, os hiperparâmetros e a política de features são congelados, o classificador selecionado é treinado uma vez sobre treino + validação, totalizando 11.569 observações, e avaliado na partição final de teste com 2.042 observações.
Os resultados científicos finais são:
Macro F1 — 0,941835
Acurácia Balanceada — 0,939897
Acurácia — 0,932419
Log Loss — 0,181024
Os resultados permanecem próximos entre validação e teste final nas principais métricas de avaliação.
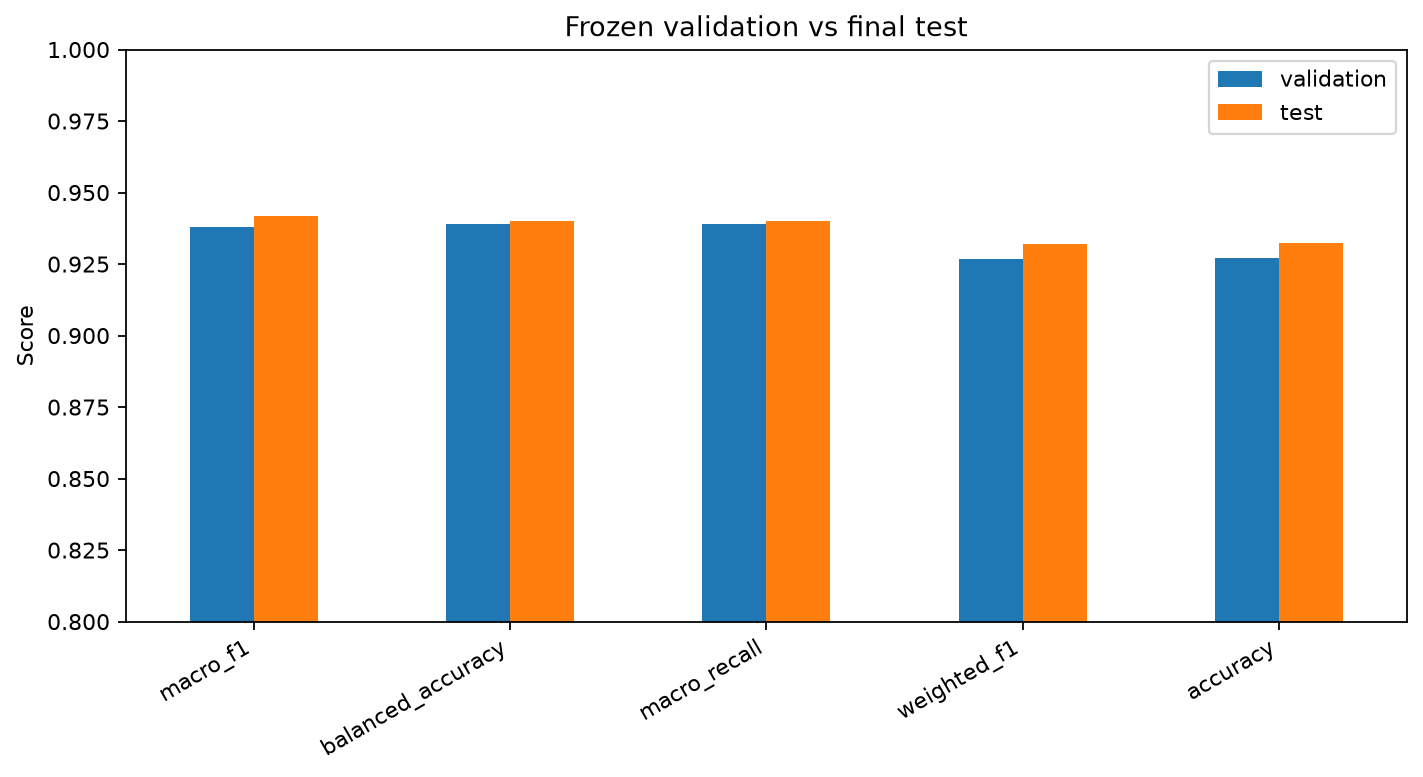
O Macro F1 varia aproximadamente +0,003954 entre validação e teste final, enquanto a Acurácia Balanceada varia aproximadamente +0,000766. Essas diferenças constituem evidência descritiva de generalização e não são utilizadas como novos critérios de seleção.
A matriz de confusão do teste final permite observar com mais detalhe onde permanecem os erros de classificação.
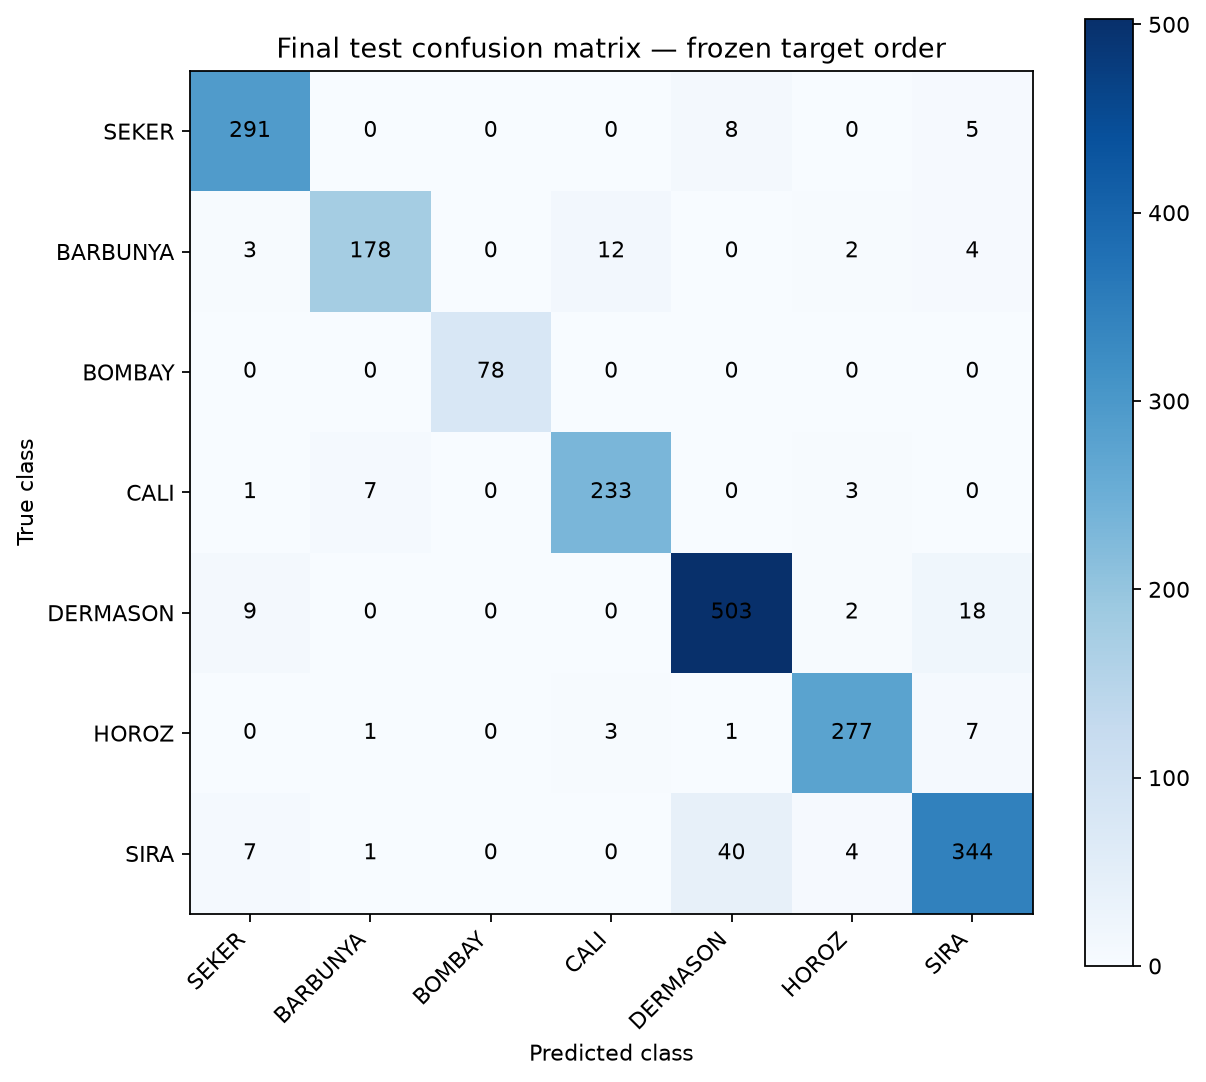
A maioria das previsões está concentrada na diagonal.
A maior confusão mútua ocorre entre:
DERMASON ↔ SIRA — 58 erros
seguida de:
BARBUNYA ↔ CALI — 19 erros
SIRA apresenta o menor recall no teste final, aproximadamente 0,8687.
Como se trata de um problema com sete classes, não existe classe positiva nem threshold binário de decisão. A previsão utiliza argmax: é retornada a classe que recebe a maior probabilidade prevista.
04 — Principais conclusões e limitações
O estudo mostra que medidas numéricas relacionadas ao tamanho e à forma dos grãos contêm forte informação preditiva para distinguir as sete variedades dentro deste dataset e deste protocolo de avaliação.
A comparação dos modelos também mostra por que a conclusão científica não deve ser reduzida à afirmação de que uma configuração de features superou claramente todas as alternativas. As duas configurações mais fortes de HistGradientBoosting permanecem dentro da tolerância previamente definida de empate prático, com a Acurácia Balanceada resolvendo o empate em favor da representação completa com 16 features.
O desempenho permanece semelhante entre validação e teste final, enquanto a análise da matriz de confusão mostra que os erros residuais estão mais concentrados entre algumas variedades morfologicamente sobrepostas em vez de se distribuírem uniformemente.
Uma limitação importante diz respeito ao histórico da partição de teste final.
Na execução canônica corrigida, o teste não participa da análise exploratória dependente do target, validação cruzada, busca de hiperparâmetros, definição das políticas de features ou seleção do modelo. Entretanto, a mesma partição de teste associada ao seed 42 já havia sido avaliada uma vez por uma execução anterior posteriormente substituída, cuja análise exploratória dependente do target e das distribuições utilizava o dataset completo.
O estudo corrigido reconstruiu suas decisões de desenvolvimento utilizando evidências exploratórias somente do treino, sem alterar o split previamente definido, o espaço de candidatos, as métricas, os seeds ou as regras de desempate. A execução corrigida reproduziu os resultados numéricos anteriores.
Ainda assim, a partição final de teste não pode ser descrita como um holdout que nunca havia sido aberto anteriormente.
A fonte também contém perfis de features repetidos. Quinze observações do teste final apresentam um perfil completo também observado em treino + validação. Ao excluir essas observações, o Macro F1 varia apenas de 0,941835 para 0,941523, mas a igualdade dos perfis não permite concluir que os registros representem o mesmo grão físico, pois a fonte não fornece identificadores de observação.
A avaliação utiliza um snapshot aleatório estratificado, e não validação temporal, prospectiva ou externa. A representatividade externa não foi estabelecida.
O estudo avalia medidas numéricas que já foram extraídas das imagens. Ele não avalia o processo completo anterior de aquisição das imagens, segmentação ou obtenção das medidas.
A procedência da fórmula de origem de ShapeFactor2 permanece não resolvida dentro da tolerância numérica configurada. Sua sensibilidade preditiva é avaliada explicitamente, mas mantê-la no modelo selecionado não resolve nem cria uma procedência para sua fórmula de origem.
O estudo também não estabelece relações causais entre morfologia e variedade, calibração universal das probabilidades, desempenho equivalente em diferentes populações ou sistemas de aquisição, estabilidade diante de futuras mudanças de distribuição ou prontidão para produção.
Dentro desses limites, a conclusão científica é clara: um HistGradientBoostingClassifier utilizando todas as 16 features numéricas de morfologia apresenta forte desempenho preditivo multiclasse no dataset Dry Bean, alcançando Macro F1 de aproximadamente 0,9418 e Acurácia Balanceada de aproximadamente 0,9399 no teste final.
Este post apresenta os principais resultados científicos. O repositório do estudo contém os notebooks completos, contratos de fonte e ambiente, evidências de seleção do modelo, figuras adicionais, artefatos de reprodutibilidade e metodologia detalhada.
O Atlas DataFlow mantém as evidências de reprodução científica separadas de sua própria linhagem de treinamento e release Atlas Native. Isso preserva a distinção entre os resultados do estudo científico original, sua reprodução independente e as avaliações realizadas sob contratos próprios do Atlas.